BLOG
AI-native yazılım kalitesi üzerine notlar.
TestingOps, RunningOps, CoverOps ve ReplayOps'un arkasındaki ekipten uygulamaya dönük yazılar.
Yapay zeka kodu hızlandırdı, darboğaz kod incelemesine kaydı: Harvard araştırması ne söylüyor?
655 şirket ve 720 bin çalışanın verisi: AI ajanları kod satırını %44 artırdı, tamamlanan iş yalnızca %13,7 arttı. Aradaki fark kod incelemesinde birikiyor; onay süresi %56 uzadı.
Oku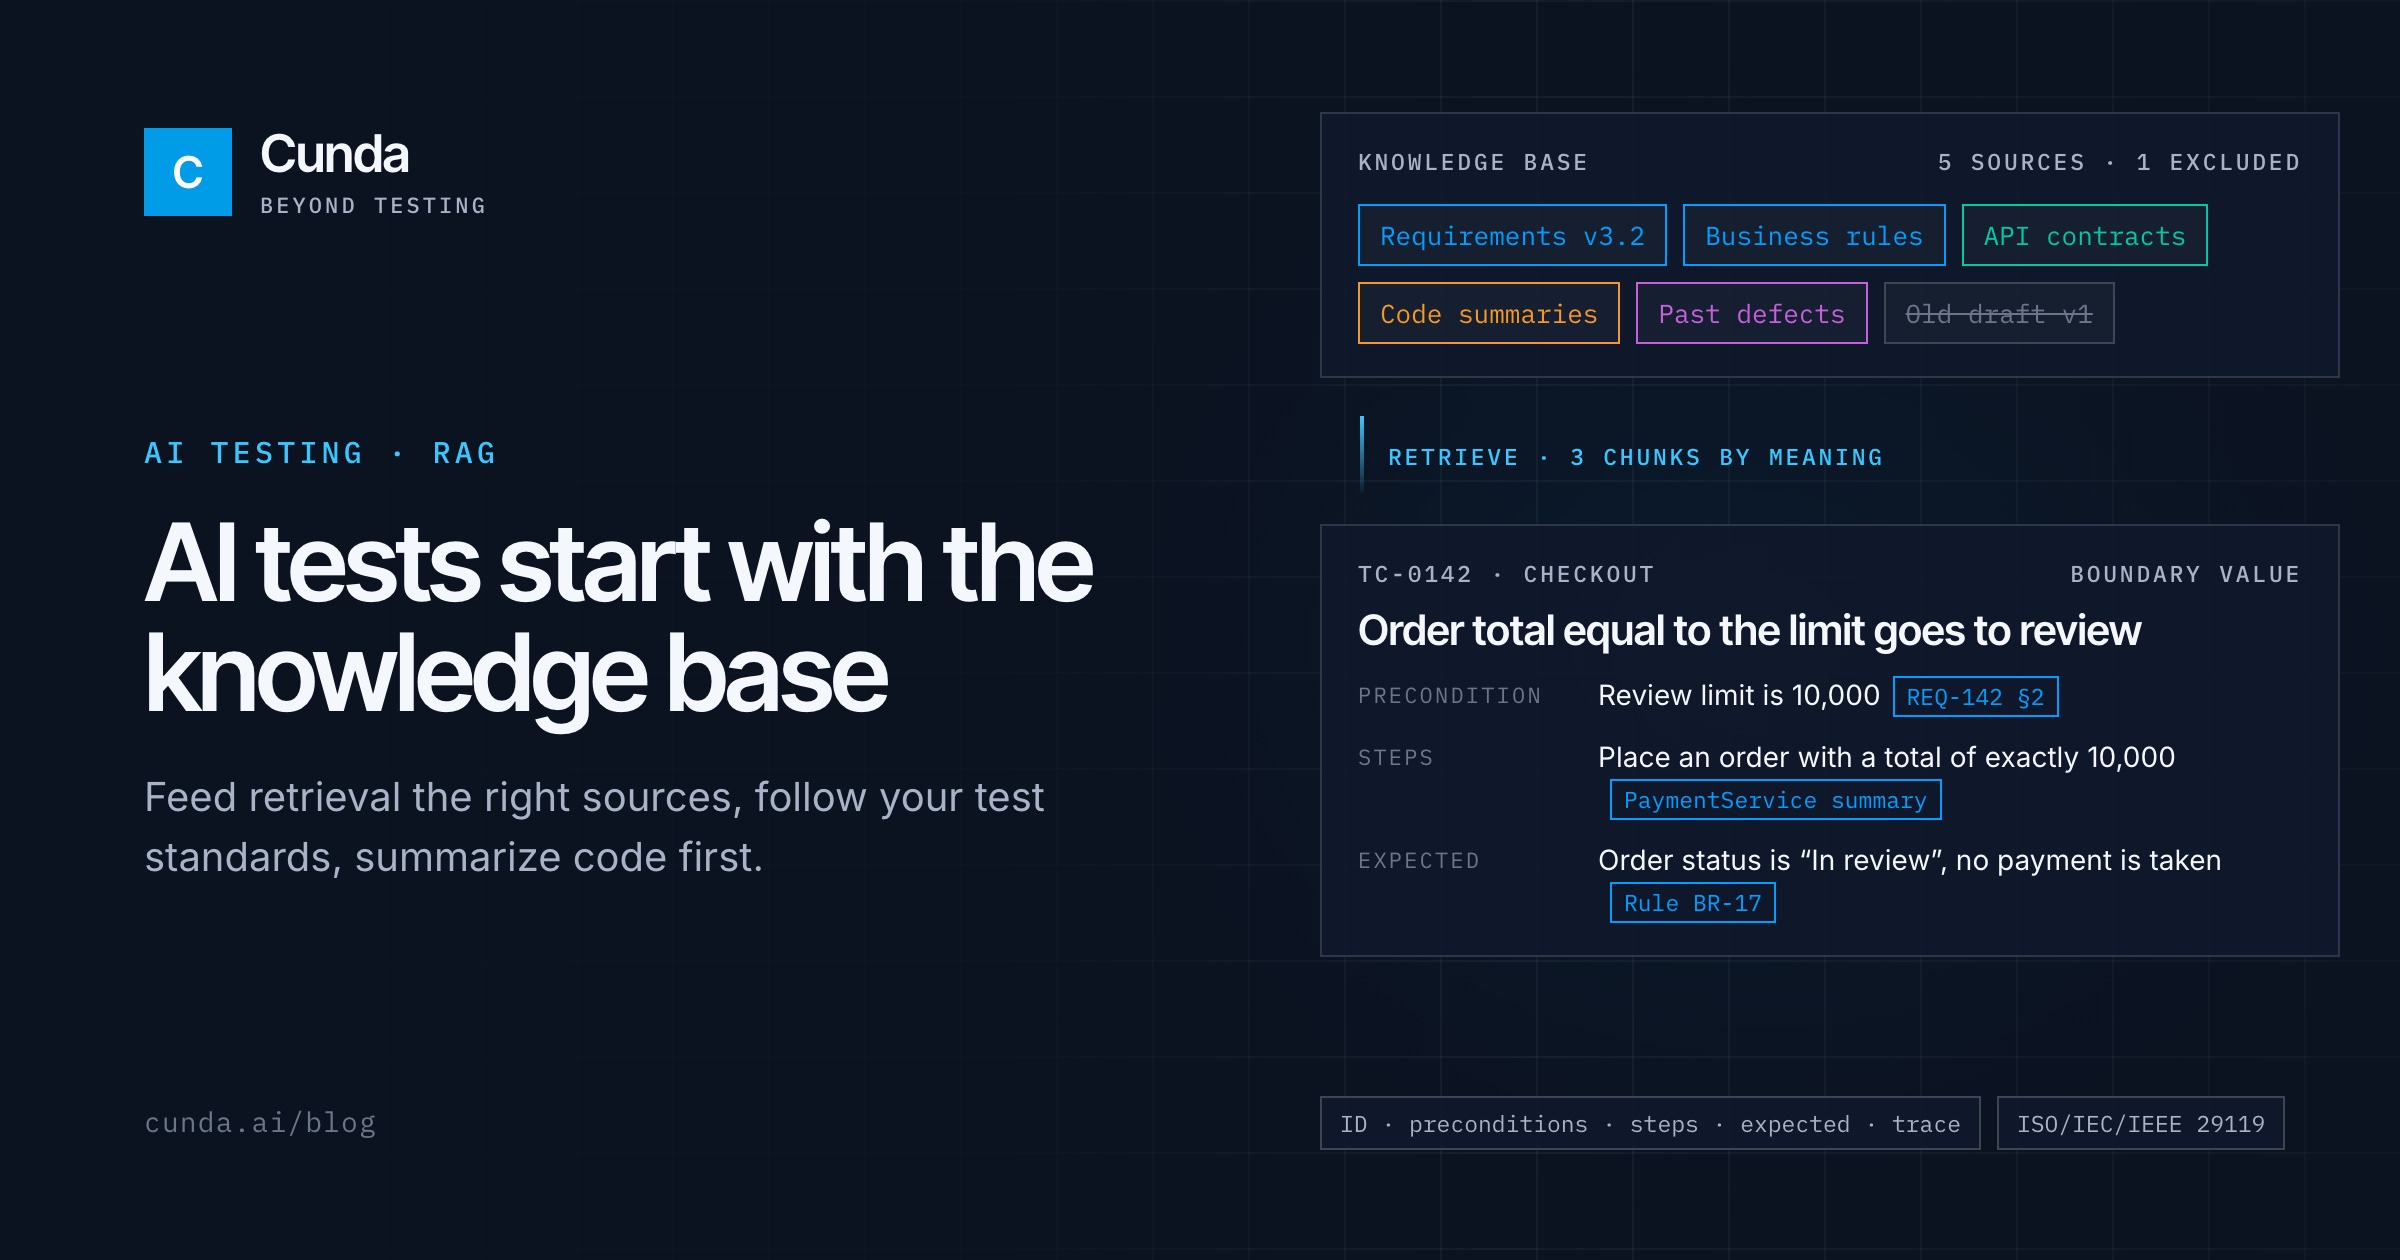
Yapay zeka ile test, bilgi tabanı kadar iyidir: RAG, test standartları ve kodu özetlemek
Test yazan bir model yalnızca ona verdiğiniz kadarını bilir. Yapay zeka ile testin kalitesine üç şey karar verir: RAG ile doğru beslenen bir bilgi tabanı, test standartlarınıza uyan testler ve modele ulaşmadan önce özetlenen kaynak kod.
Oku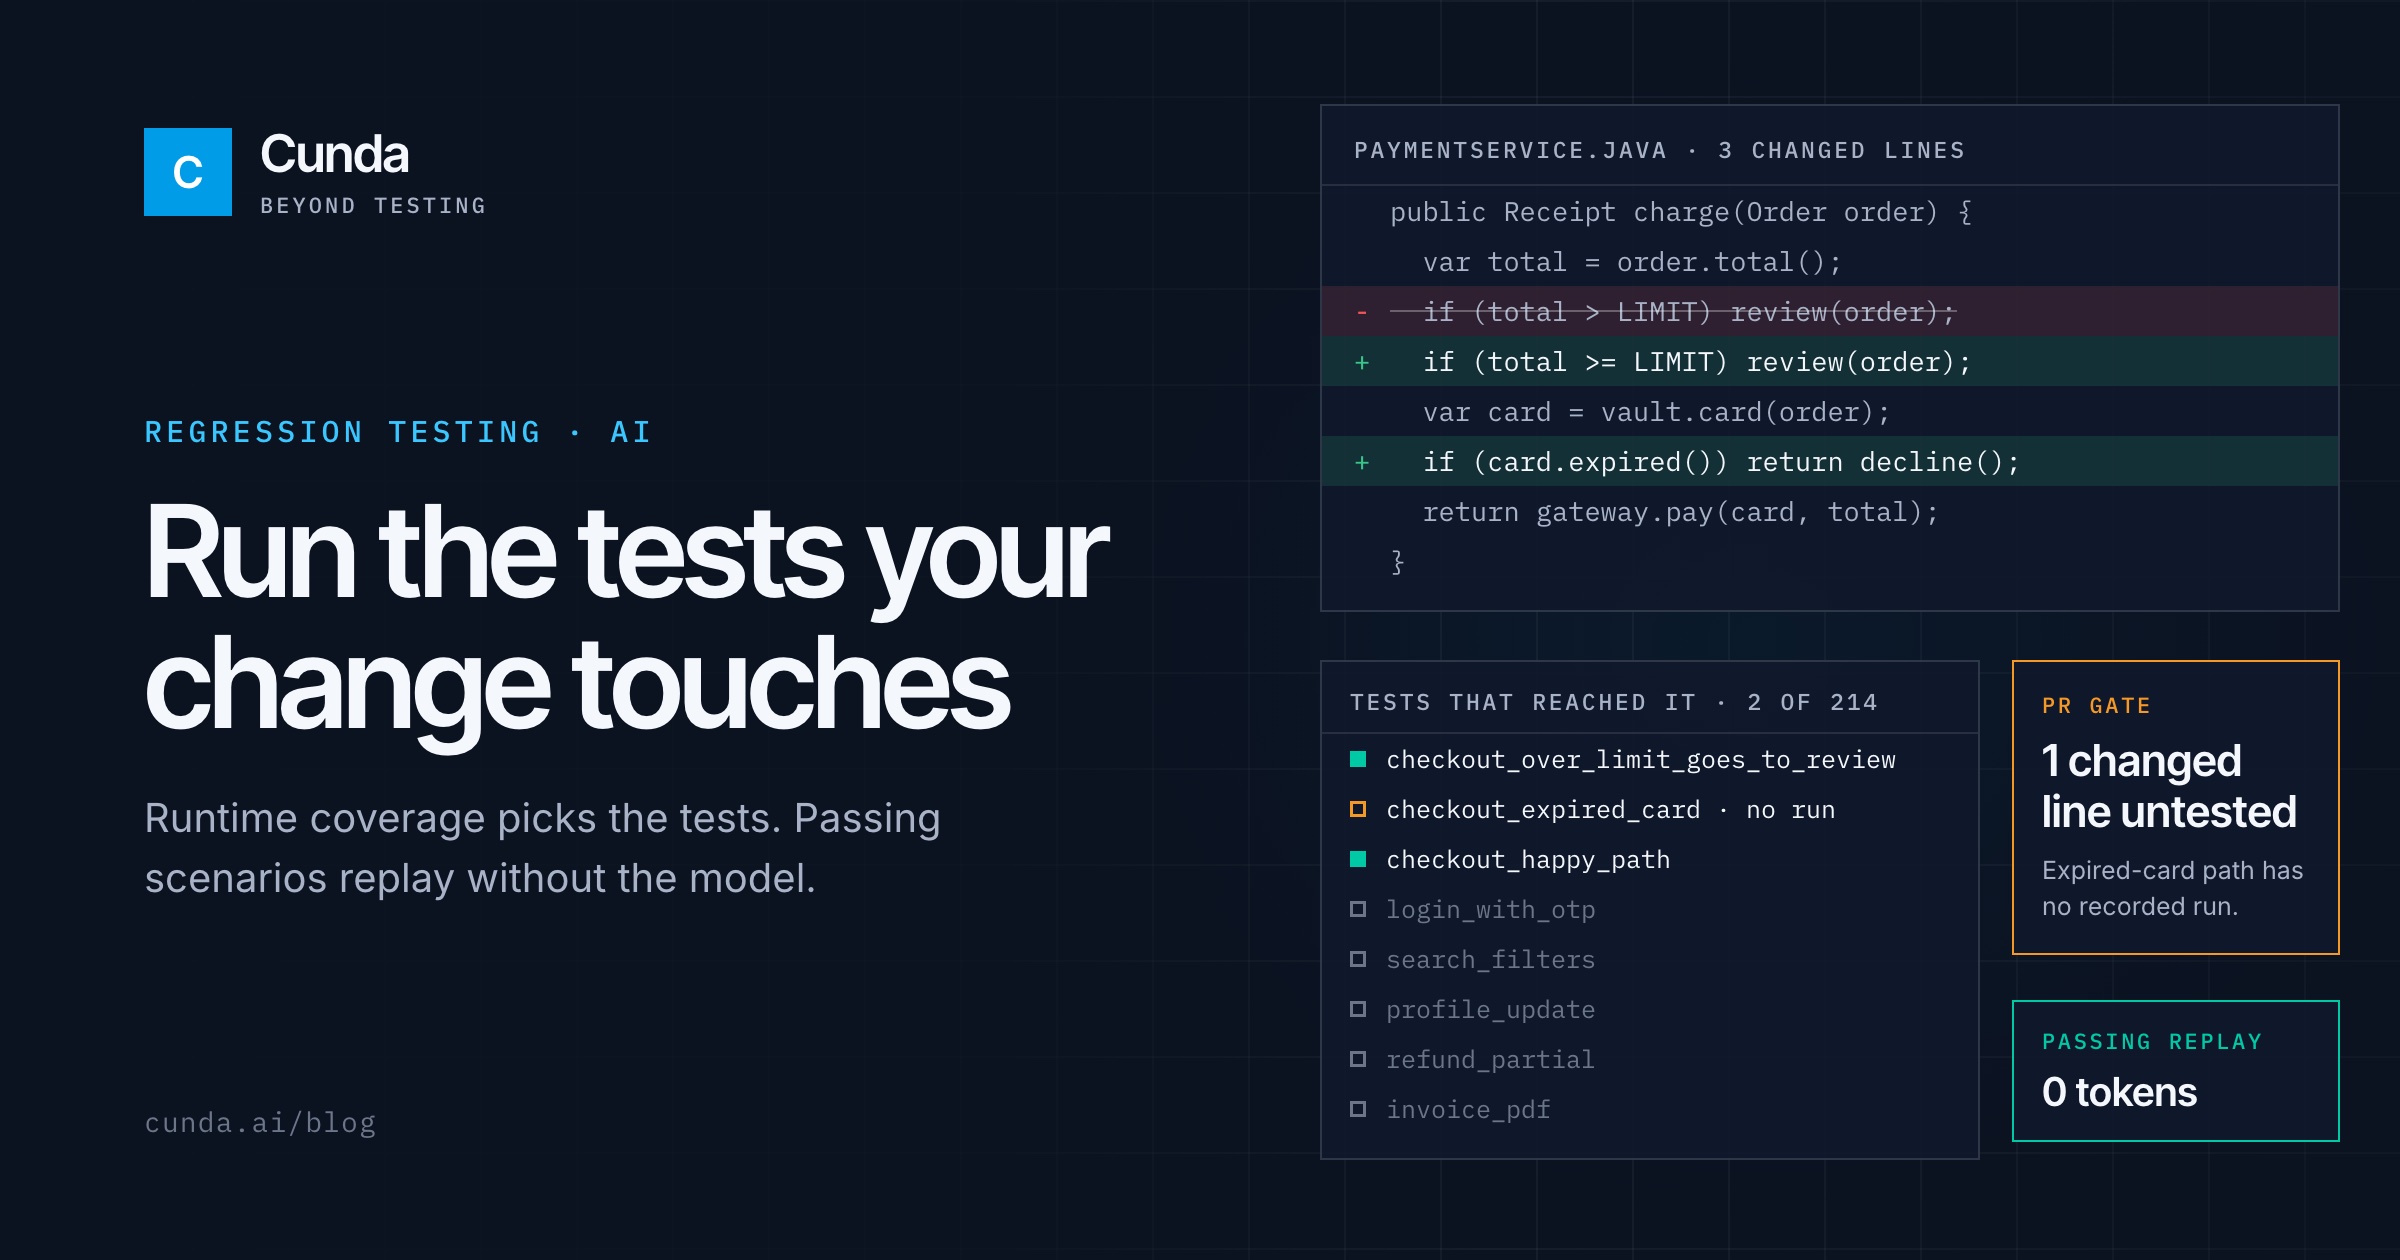
Regresyon testinde yapay zeka: değişikliğin dokunduğu testleri koşturun
Regresyon setleri kimsenin bakımına yetişemeyeceği hızda büyür. Yapay zeka üç yerde yardım eder: testleri değişikliğin dokunduğu koda göre seçmek, ürün değişince testleri ayakta tutmak ve koşturma maliyetini sabit tutmak.
Oku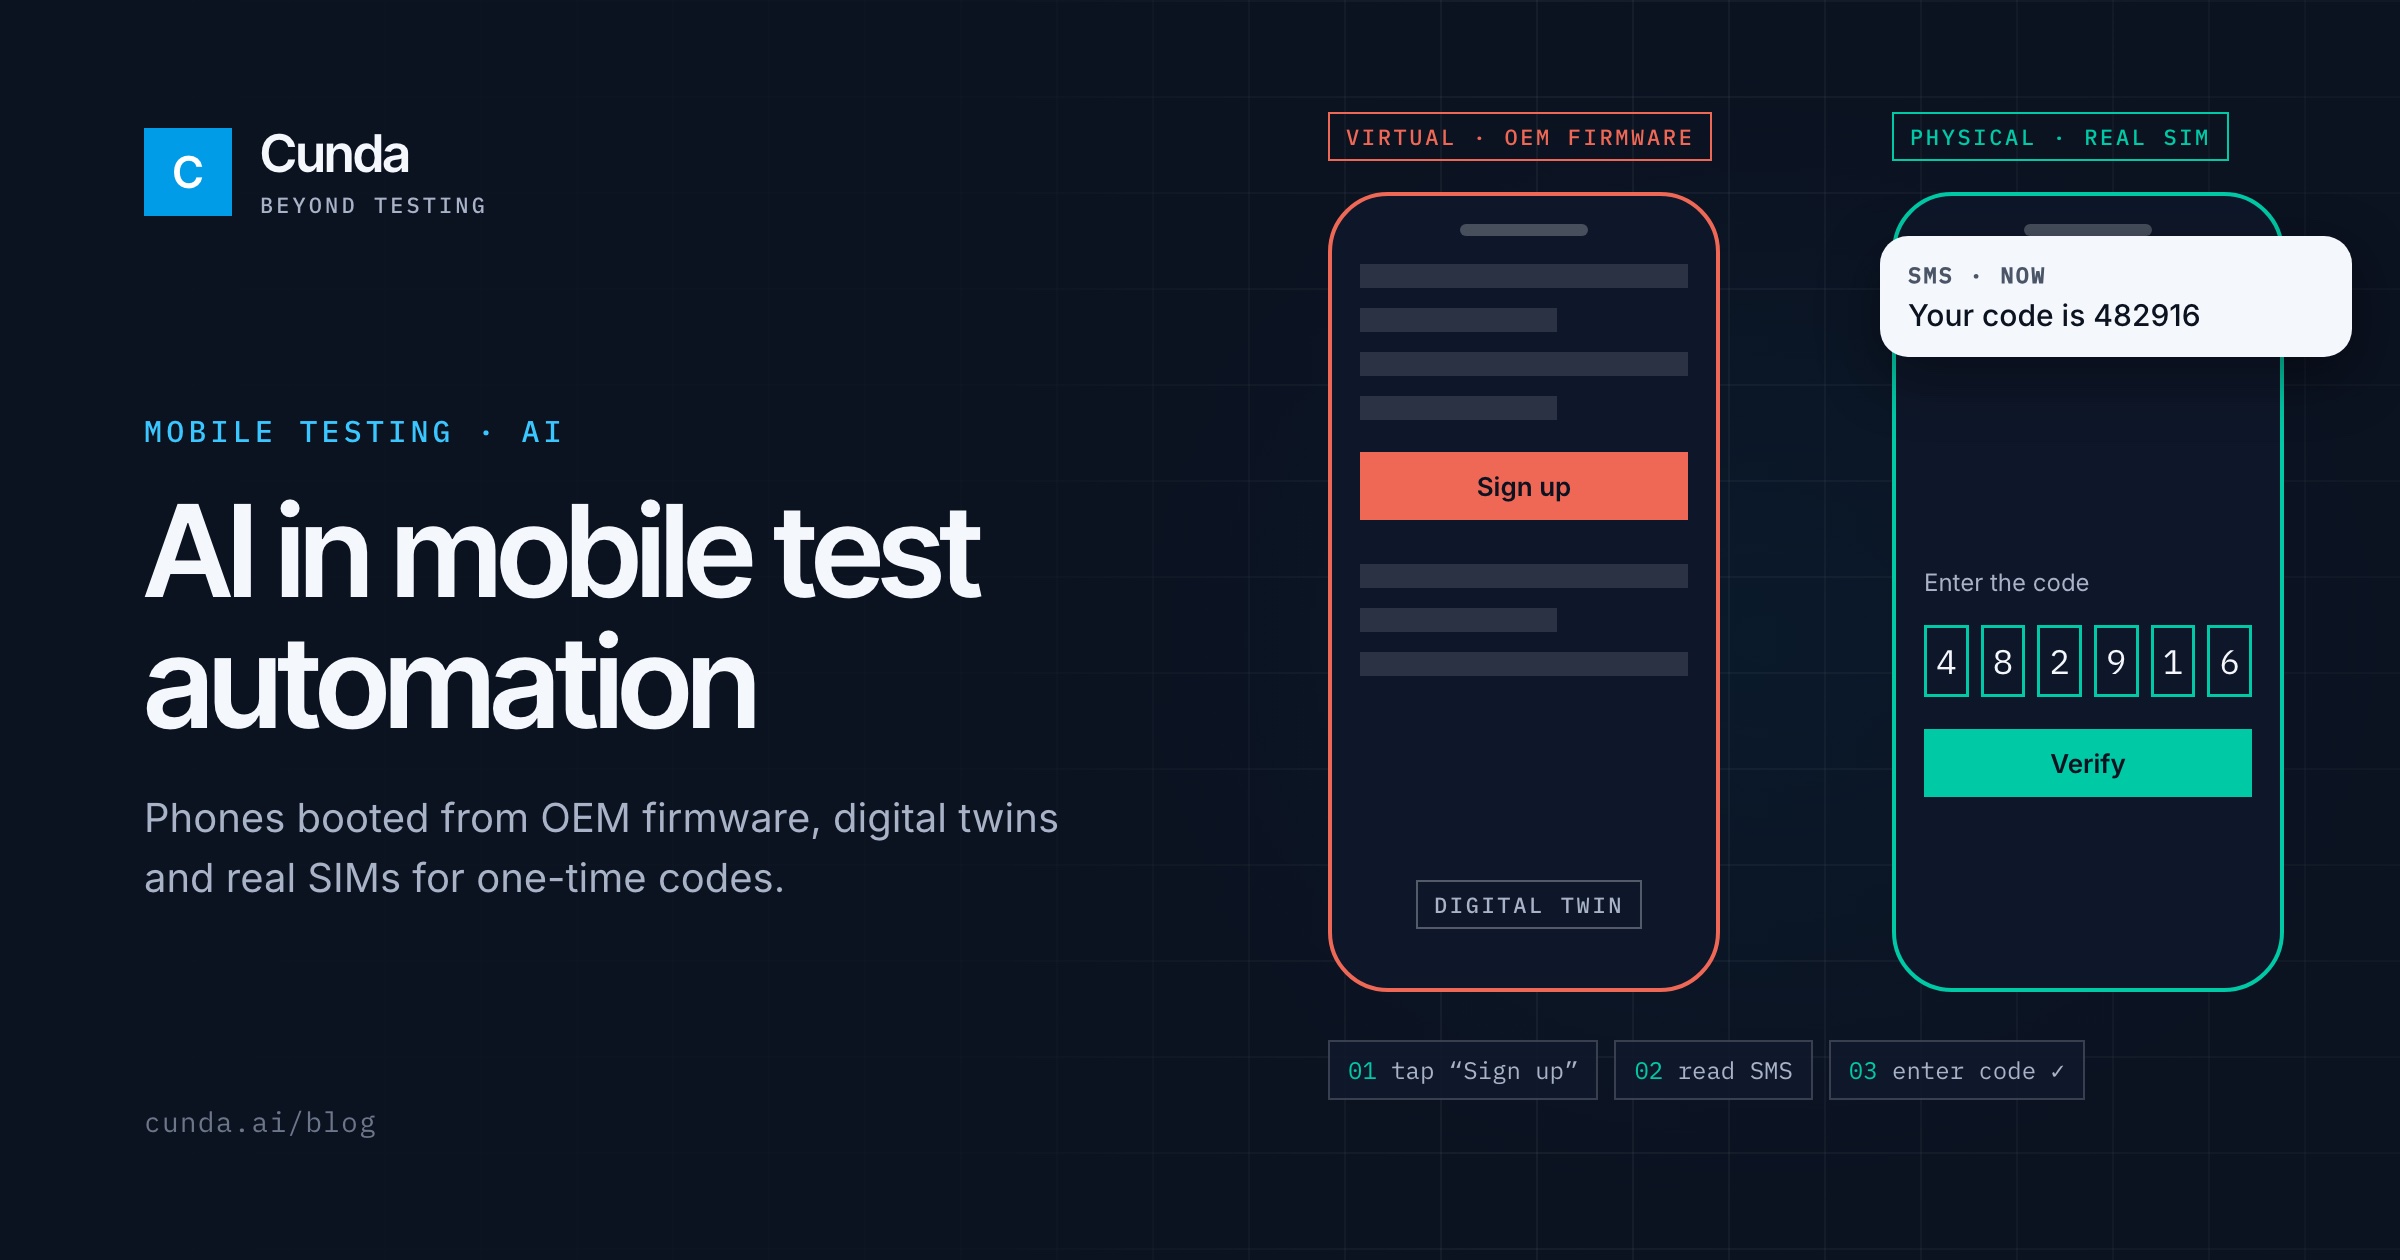
Mobil test otomasyonunda yapay zeka: cihazlar, tek kullanımlık kodlar ve dijital ikizler
AI agent'lar mobil testlerin nasıl yazıldığını değiştirir, ama bir akışın test edilip edilemeyeceğine hâlâ cihaz ve SMS kodu karar verir. Agent'ların kattıkları, sanal cihazların ve dijital ikizlerin işe yaradığı yerler ve gerçek SIM'li telefonun gerektiği durumlar.
Oku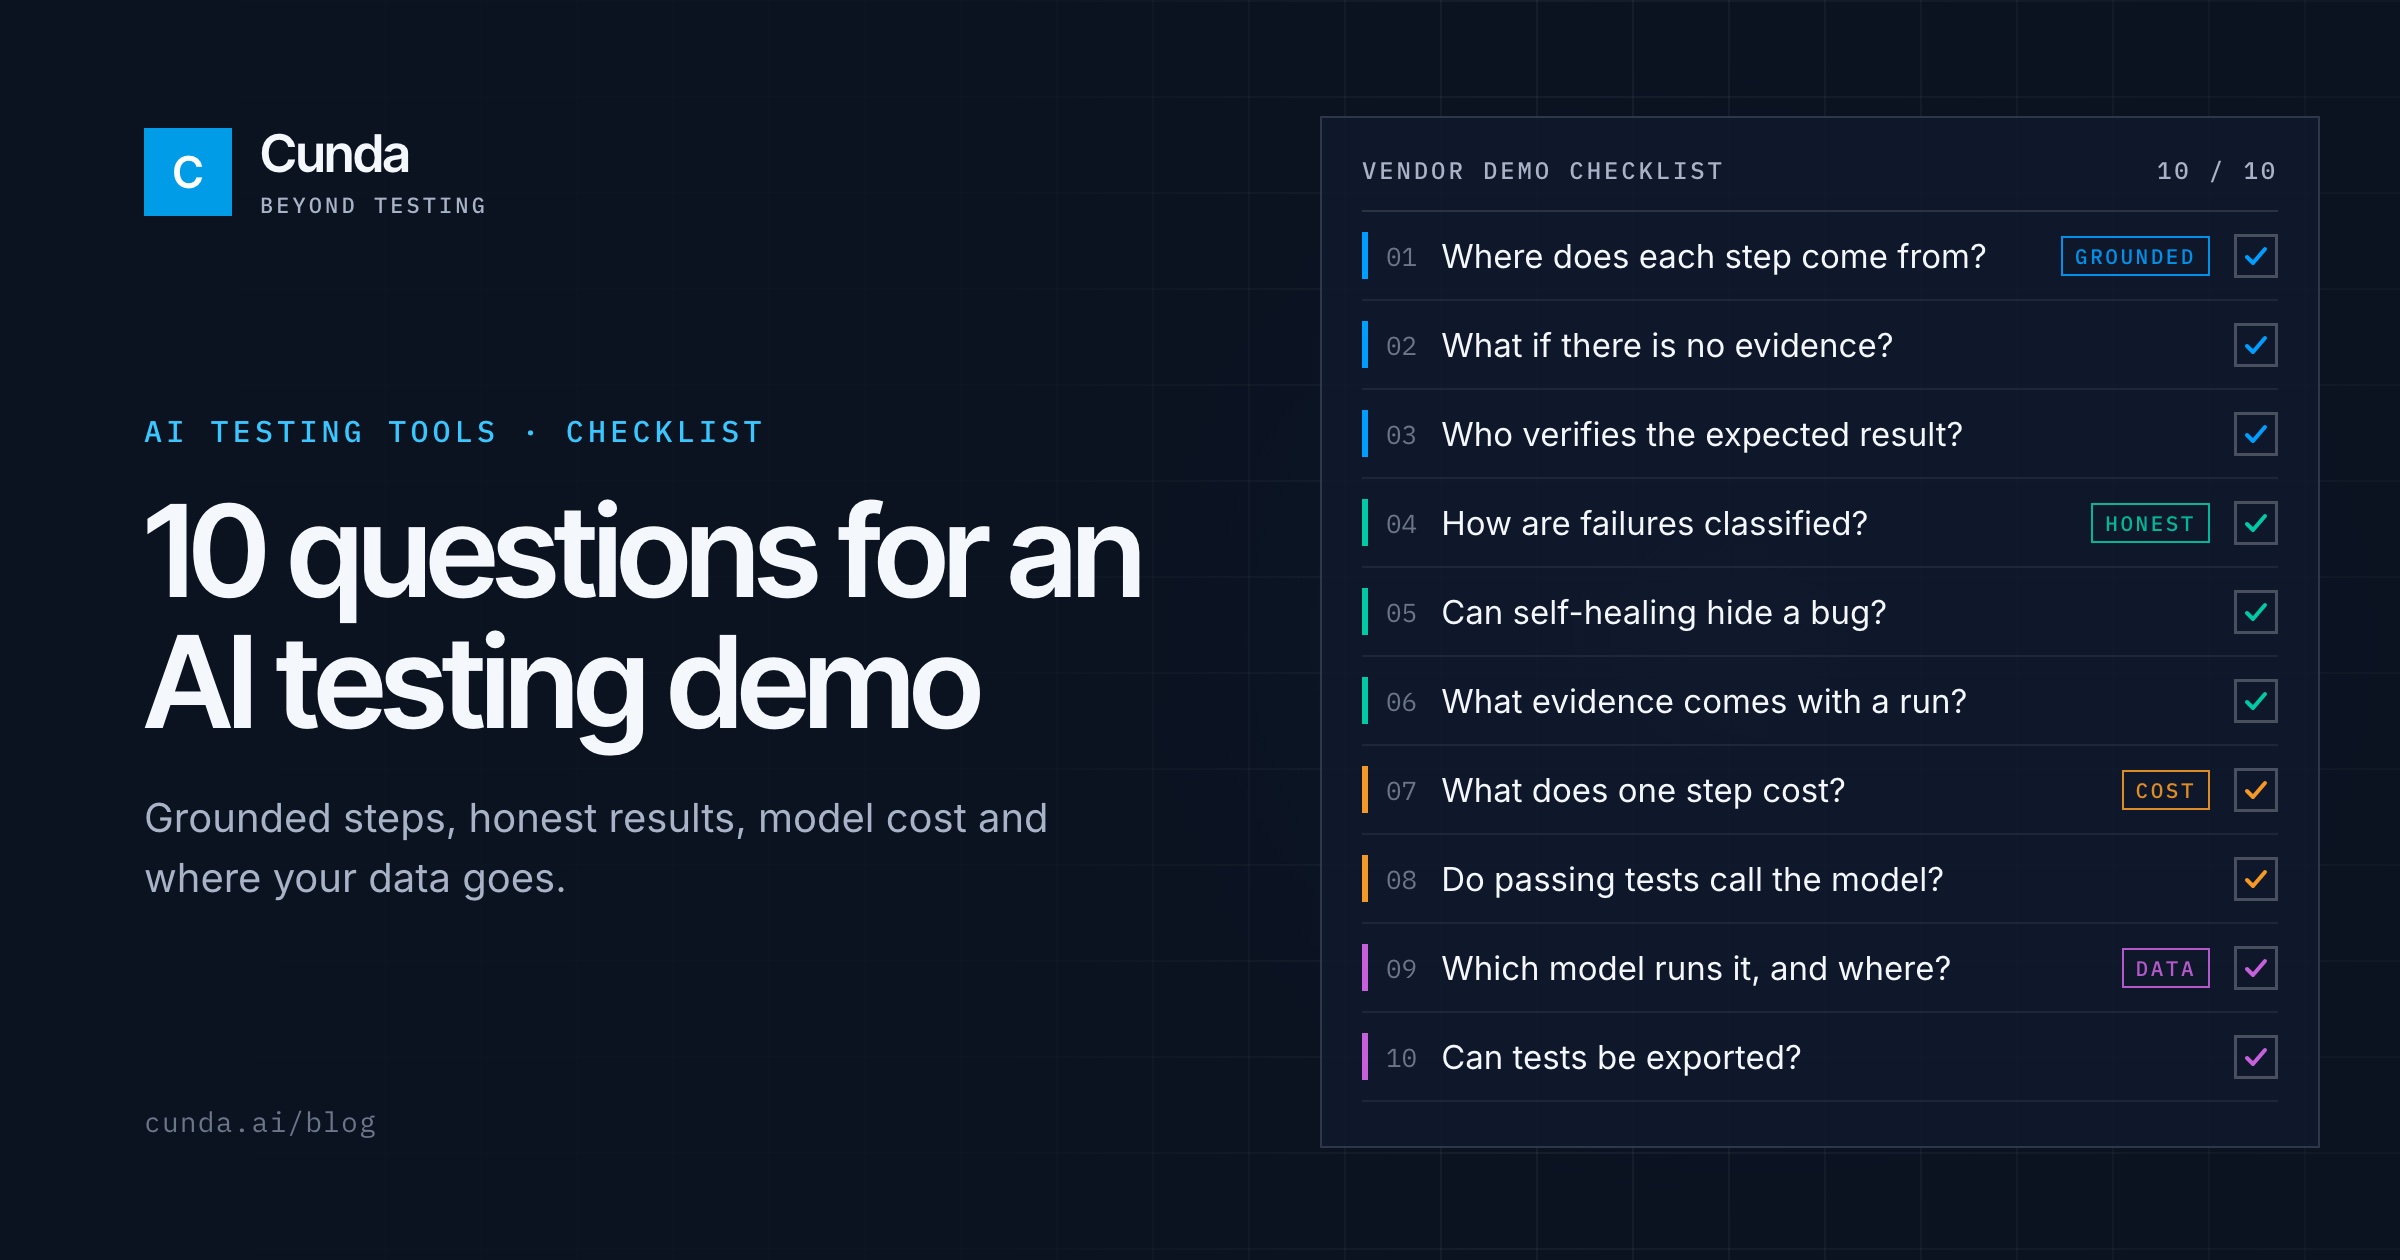
Yapay zeka test araçları nasıl karşılaştırılır? Demoda sorulacak 10 soru
Neredeyse her test aracı artık yapay zeka kullandığını söylüyor. Bu on soru farkı demoda gösterir: her adım nereden geliyor, yeşil sonuca güvenilir mi, bir koşu neye mal oluyor ve veriniz nereye gidiyor.
Oku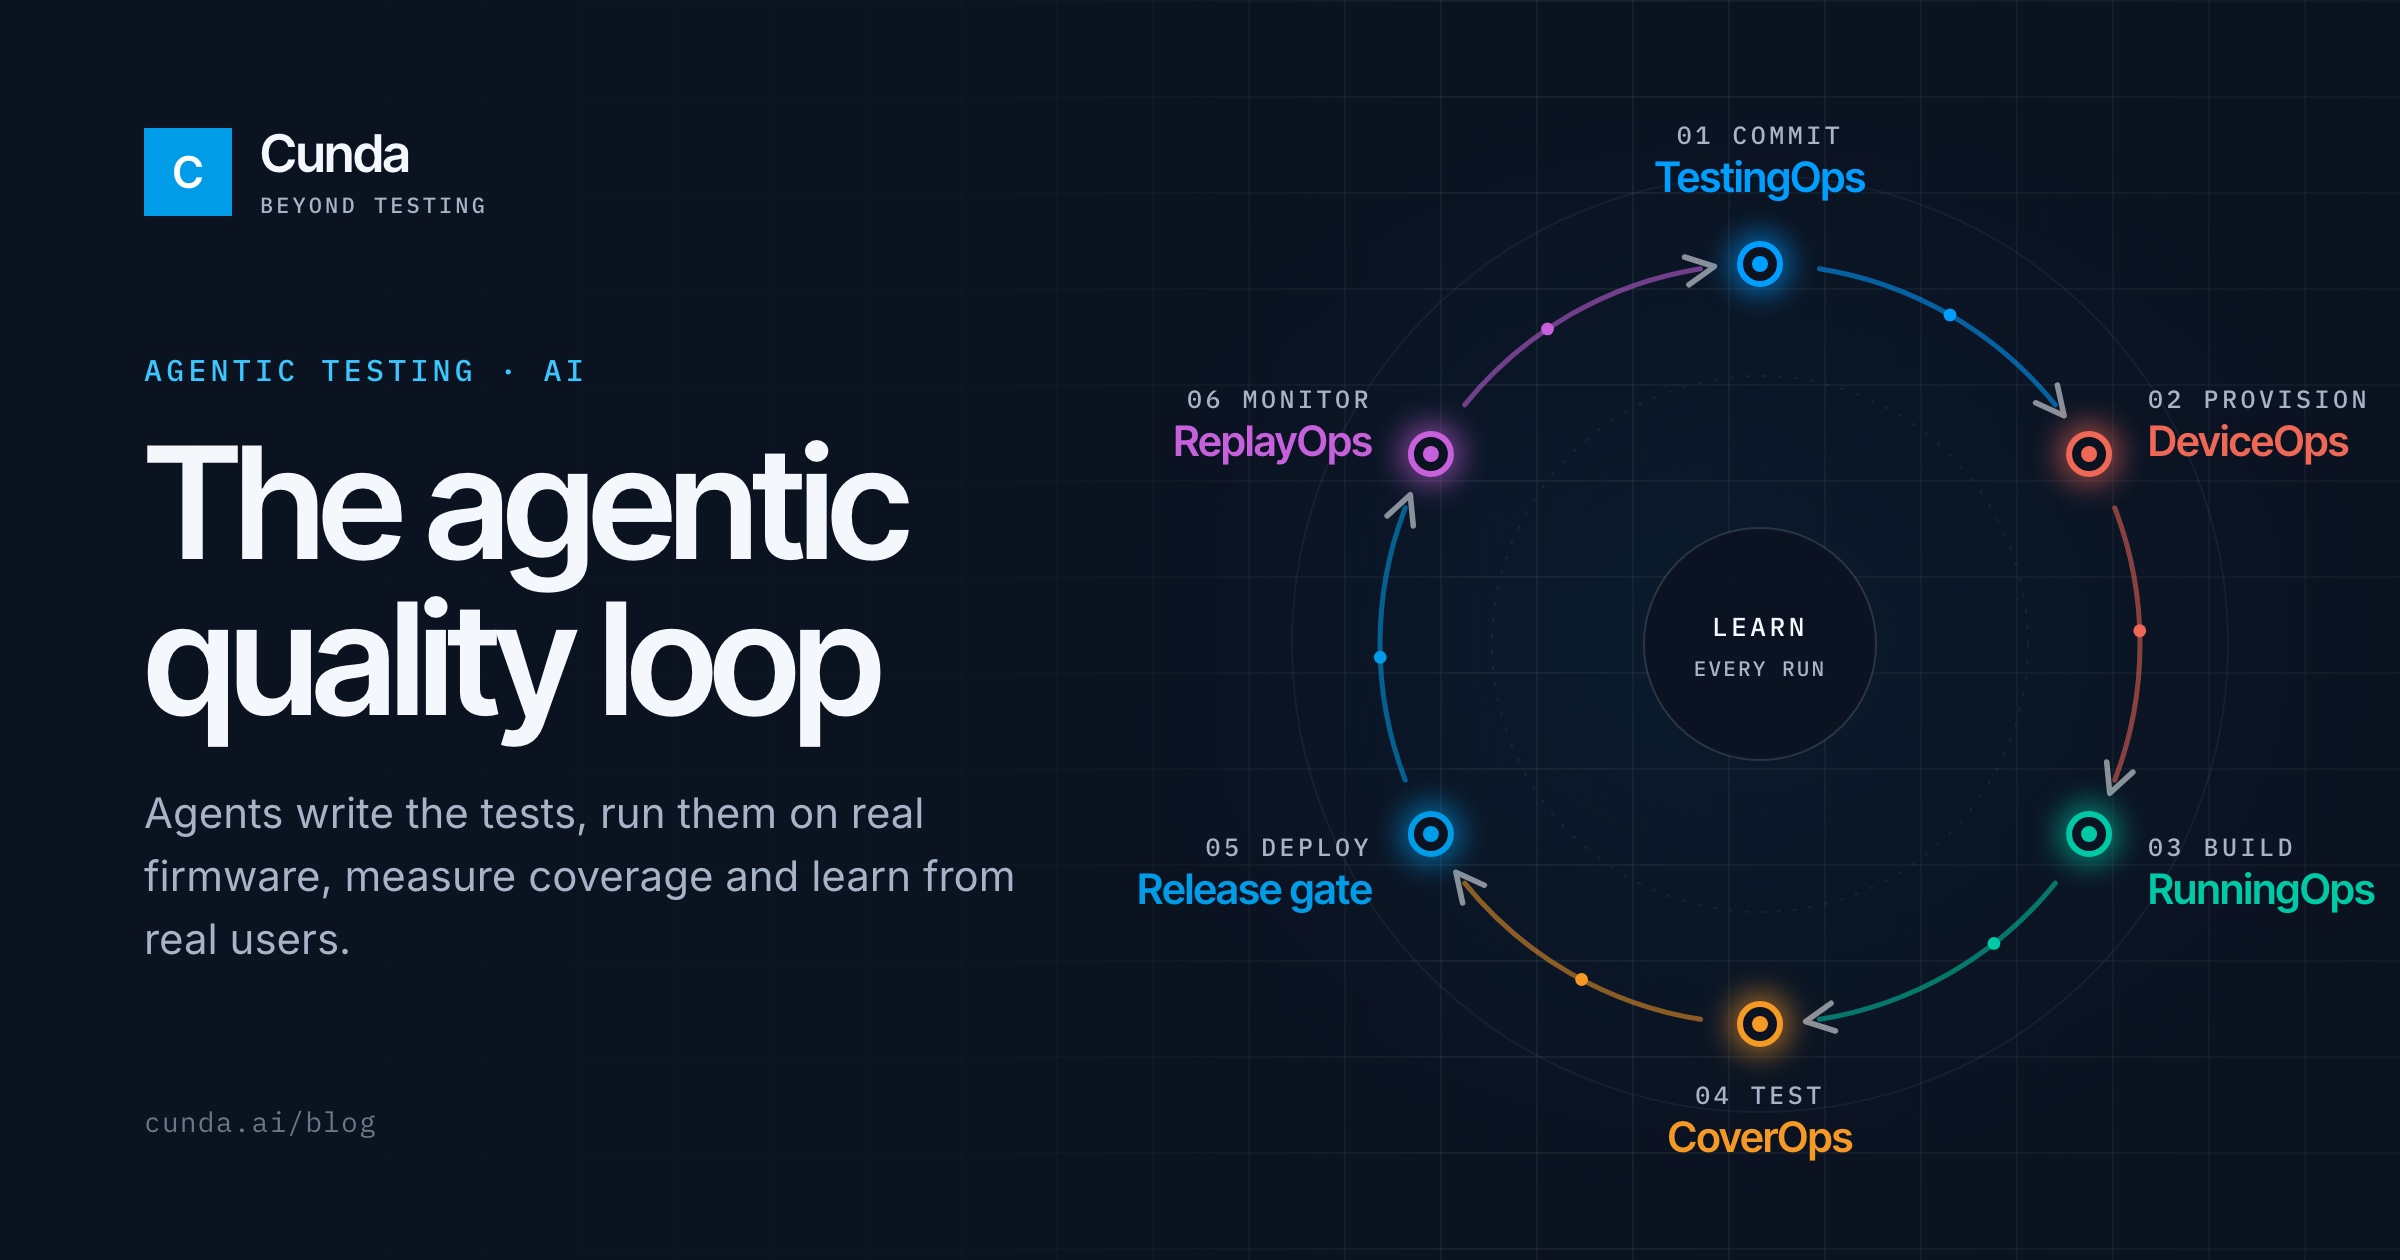
Test otomasyonundan agentic kalite döngüsüne: Cunda nasıl çalışır?
Testleri üreten agent'lar, gerçek firmware'den açılan sanal telefonlar, çalışan servislerde ölçülen kapsam ve gerçek kullanıcı oturumları. Cunda'nın beş ürününün tek bir kalite döngüsünde nasıl birleştiğini anlatıyoruz.
Oku